OpenEdge AI Assistant: del conocimiento especializado al trabajo verificable
La inteligencia artificial mejora cuando mejora el conocimiento al que puede acceder.
Ese principio empieza a tomar una forma concreta en OpenEdge.
OpenEdge AI Assistant ya permitía llevar asistencia especializada sobre OpenEdge y ABL a las herramientas de desarrollo con inteligencia artificial. Progress lo plantea como apoyo para generar código, refactorizar aplicaciones existentes, automatizar tareas y avanzar en procesos de modernización.
En 2026 amplió ese contexto con todos los artículos de la OpenEdge Knowledge Base publicados hasta junio de ese año. Así, el asistente incorpora también conocimiento acumulado sobre errores, PASOE, AppServer, bases de datos, bugs conocidos, workarounds y resoluciones históricas de soporte.
Para desarrolladores, arquitectos, administradores y equipos de soporte, el cambio es significativo. Parte de la información que antes exigía recorrer documentación, portales de soporte y antecedentes ahora puede estar disponible dentro del mismo entorno donde trabaja el agente, incluso desde herramientas compatibles con MCP como Claude Code.
Esto mejora la calidad del punto de partida.
Y también desplaza el desafío.
Cuanto más conocimiento especializado tiene un agente, más importante se vuelve definir bajo qué reglas debe utilizarlo, qué decisiones puede tomar y qué evidencia necesita dejar sobre el trabajo realizado.
Décadas de conocimiento de OpenEdge dentro del flujo de trabajo de la IA
Uno de los problemas de utilizar modelos generales en desarrollo es que pueden conocer un lenguaje o reconocer un patrón sin disponer del contexto específico de una plataforma.
En OpenEdge eso puede hacer una diferencia importante.
Un error poco frecuente, un problema de arranque de PASOE o un comportamiento inesperado de una base de datos pueden depender de antecedentes, configuraciones, bugs conocidos o procedimientos que forman parte de años de experiencia acumulada alrededor de la plataforma.
La ampliación de OpenEdge AI Assistant permite recurrir a ese conocimiento desde el mismo flujo de trabajo de la IA.
Ya no se trata solamente de buscar más rápido. La procedencia del conocimiento empieza a formar parte de la calidad de la respuesta.
Frente a un error, por ejemplo, el agente puede apoyarse en información específica y documentada de OpenEdge en lugar de depender únicamente de los supuestos generales del modelo.
Progress incluso plantea que las organizaciones pueden configurar reglas del workspace, instrucciones globales o skills para indicar cuándo el asistente debe consultar la Knowledge Base: ante errores, números de error, fallas de inicio, problemas operativos o situaciones de troubleshooting.
El agente no solo puede disponer de una fuente mejor.
También puede recibir instrucciones para saber cuándo recurrir a ella.
Y ahí aparece una posibilidad más amplia.
Saber qué recomienda OpenEdge no define todavía qué corresponde hacer
Supongamos que una instancia de PASOE no inicia correctamente. OpenEdge AI Assistant puede encontrar antecedentes relacionados con el error, identificar un bug conocido, recuperar un workaround o señalar un procedimiento recomendado. Eso reduce una parte importante de la investigación.
Pero después aparecen otras preguntas: ¿Qué versión utiliza esa aplicación? ¿Cómo está configurado ese entorno? ¿Qué componentes dependen de la instancia? ¿Existen excepciones propias? ¿Qué modificaciones están permitidas? ¿Quién debe aprobarlas? ¿Qué pruebas hacen falta antes de considerar solucionado el incidente?
Esas respuestas pertenecen a otra capa de conocimiento.
Cada aplicación acumula con el tiempo decisiones, convenciones, restricciones, integraciones y criterios que no necesariamente forman parte de la documentación del fabricante. Por eso, la misma lógica que permite indicarle a un agente cuándo debe buscar conocimiento especializado de OpenEdge puede extenderse hacia otra pregunta: ¿Bajo qué reglas debe utilizarlo para trabajar sobre nuestra aplicación?
En este artículo habíamos analizado que modernizar también implica construir una forma conocida y repetible de volver a cambiar el sistema. Con agentes de IA, esa necesidad se extiende al propio proceso de desarrollo.
Del conocimiento técnico a las reglas de trabajo
Ahí entra Spec OE, nuestra implementación de desarrollo guiado por especificaciones para OpenEdge.
Su función no es volver a enseñarle OpenEdge al agente. Si Progress puede aportar conocimiento especializado y actualizado sobre la plataforma, Spec OE puede concentrarse en otra dimensión: las reglas bajo las que ese conocimiento debe utilizarse dentro de una aplicación concreta.
Una especificación puede establecer qué problema debe resolverse, cuál es el alcance de la tarea, qué componentes pueden modificarse, qué convenciones deben respetarse y qué validaciones son necesarias.
Las instrucciones, skills y contratos de rol pueden definir además los límites de actuación.
Un agente puede estar habilitado para investigar un incidente y proponer una modificación sin estar autorizado a aplicarla directamente. Otro puede implementar el cambio, mientras una persona conserva la responsabilidad de revisarlo y aceptarlo.
Esta distinción empieza a ser central: lo que un agente sabe no determina automáticamente lo que puede hacer.
El conocimiento especializado mejora el análisis. Las reglas de la organización determinan cómo puede convertirse en trabajo.
Pero todavía queda una pregunta: ¿qué conserva la organización una vez terminado ese trabajo?
Una respuesta útil también necesita dejar evidencia
Una conversación con un agente puede contener mucha información mientras una tarea está abierta. El problema aparece después. ¿Por qué se eligió una solución? ¿Qué alternativas se descartaron? ¿Qué documentación se consultó? ¿Qué cambió finalmente? ¿Qué prueba permitió aceptar el resultado?
Si esas respuestas quedan distribuidas entre chats, tickets, repositorios y memoria individual, la organización puede resolver un problema sin conservar la experiencia que generó al resolverlo. Es otra forma de la dependencia del conocimiento concentrado que aparece cuando los sistemas siguen funcionando, pero cada cambio depende de quienes recuerdan su historia. Algo de lo que hablamos en este artículo.
Con agentes esto puede volverse todavía más visible. Una persona define la necesidad, un agente investiga, otro modifica código y alguien diferente revisa el resultado.
Ahí aparece la función de Integra Hub: relacionar especificaciones, tareas, decisiones, revisiones y pruebas para que un cambio no quede aislado del problema que lo originó ni de la evidencia con la que fue validado.
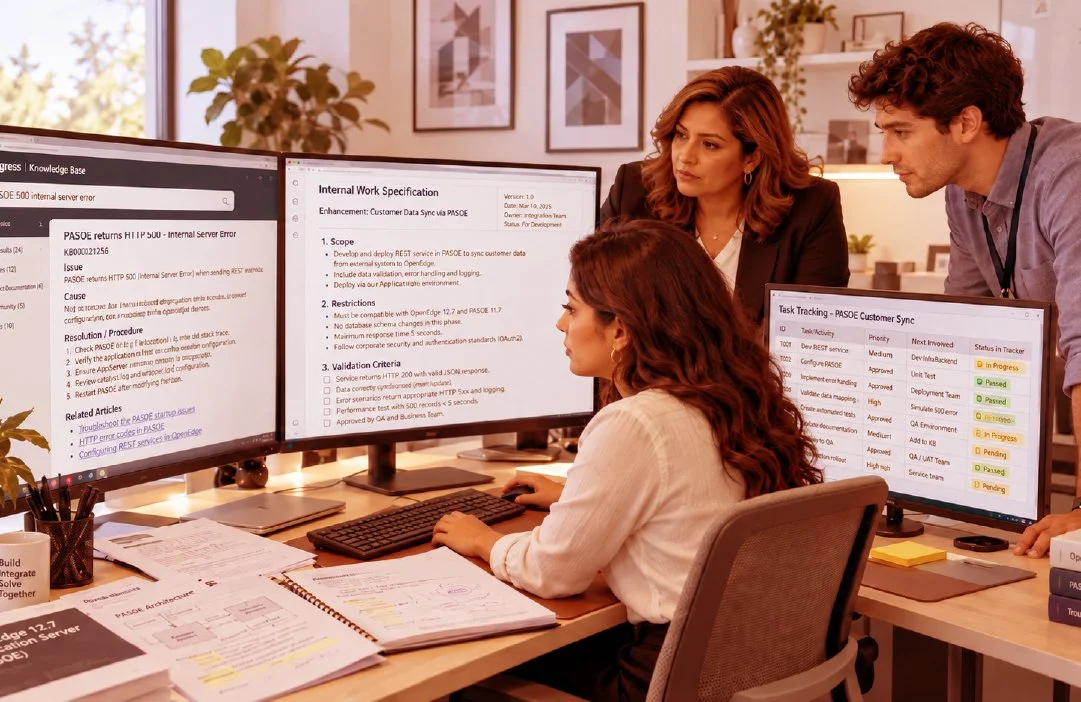
En un problema de arranque de PASOE, por ejemplo, OpenEdge AI Assistant puede aportar antecedentes y procedimientos documentados. Spec OE puede orientar al agente sobre las reglas aplicables a ese entorno, mientras Integra Hub conserva las decisiones tomadas durante la resolución y las pruebas que permitieron comprobar el resultado.
Si una situación similar aparece meses después, esa experiencia no tiene que reconstruirse desde cero. La organización puede recuperar qué se evaluó, qué decisión se tomó y qué resultado produjo.
Así, una incidencia resuelta puede convertirse en conocimiento reutilizable.
El conocimiento también tiene que acumularse dentro de la organización
Progress anticipa que la Knowledge Base disponible para OpenEdge AI Assistant continuará incorporando nuevo contenido. El conocimiento al que acceden los agentes, por lo tanto, puede seguir creciendo a medida que aparecen nuevas resoluciones y experiencia de soporte.
Para las organizaciones existe un desafío equivalente.
Si los agentes van a intervenir cada vez más en el desarrollo, también debería poder crecer el conocimiento sobre qué hicieron con esa información dentro de cada aplicación. Ahí es donde las capas pueden complementarse.
Progress amplía lo que el agente sabe sobre OpenEdge.
Spec OE estructura cómo debe trabajar con ese conocimiento dentro de una aplicación concreta.
Integra Hub permite gestionar y reconstruir lo que se decidió, se hizo y se comprobó.
Esto no implica una integración certificada entre las herramientas ni supone que consultar documentación garantice un diagnóstico correcto. Tampoco significa que disponer de una recomendación autorice automáticamente su ejecución.
La oportunidad está en conectar conocimiento especializado, reglas de trabajo y evidencia. Porque a medida que los agentes acceden a fuentes mejores y más actualizadas, obtener una respuesta puede volverse cada vez más sencillo.
El desafío para una organización es conseguir que lo que ocurre después también pueda repetirse, verificarse y aprovecharse.

¿Tu equipo está incorporando agentes al desarrollo OpenEdge?
En Integra podemos revisar qué conocimiento, reglas y trazabilidad necesita tu proceso para convertir mejores respuestas en una capacidad de desarrollo reutilizable.